

基于元素录井的储层矿物含量智能化计算方法
[王晔磊① ②  , 杜焕福
① ② , 席习力① ② , 张洪学① ② , 姚蒙蒙① ② , 王春伟① ② ]
, 杜焕福|
|


作者简介:王晔磊 助理研究员(自然科学),1989年生,2023年毕业于中国石油大学(华东)地质学专业,现在中石化经纬有限公司地质测控技术研究院主要从事非常规油气储层地质学与储层综合评价相关工作。通信地址:266001 山东省青岛市市南区台湾路4号。E-mail:wangyl26925.osjw@sinopec.com
针对松辽盆地长岭断陷查干花地区火石岭组火山岩矿物含量计算难题,探索利用元素录井数据高效计算矿物含量的方法。以研究区火石岭组取心井的岩屑和岩心样品为基础,获取元素录井数据及X射线衍射(XRD)矿物分析数据,利用岩心扫描照片、薄片鉴定和RoqSCAN矿物自动分析技术标定岩心、岩屑样品矿物含量真实值,经数据预处理后,采用岭回归、随机森林、极端梯度提升树(XGBoost)、轻量级梯度提升树(LightGBM)和神经网络5种机器学习算法进行训练与评估。研究表明:Al、Ca、Fe、K、Mg、Mn、Na和Si为矿物计算模型的关键建模元素;除神经网络外,其他4种算法在主要矿物的计算中表现优异, R2普遍高于0.9,均方根误差( RMSE)较低;方解石、钠长石、石英、钾长石、伊利石计算效果整体较好,其中钠长石、石英计算精度最高。该矿物含量计算方法可为基于元素录井的火山岩矿物含量快速获取与储层评价提供技术支撑。
Regarding the difficulty of calculating the mineral concentration of volcanic rocks in Huoshiling Formation,Chaganhua area of Changling fault depression in Songliao Basin,this paper explores methods to efficiently calculate the mineral concentration using element logging data. Based on rock cuttings and core samples of cored wells from Huoshiling Formation in the study area, obtain element logging data and X-ray diffraction (XRD) mineral analysis data. The true values of mineral concentration in core and rock cuttings samples are calibrated by using core scanning photographs,thin section identification and RoqSCAN mineral automatic analysis technology. After preprocessing the data,five machine learning algorithms of ridge regression,random forest,extreme gradient boosting(XGBoost),light gradient boosting machine(LightGBM),and neural network are used to carry out training and assessment. This study indicates that Al,Ca,Fe,K,Mg,Mn,Na and Si are the key modeling elements of the mineral calculation model. Except for neural network,the other four algorithms perform well in the calculation of major petrogenetic minerals,with R2 generally higher than 0.9 and root mean square error( RMSE) lower. Calcite,soda feldspar,quartz,potash feldspar and illite have achieved relatively good calculation results overall,among them soda feldspar and quartz have the highest calculation accuracy. This mineral concentration calculation method provides technical support for quickly obtaining the volcanic rock mineral concentration based on element logging and reservoir evaluation.
火山岩矿物组成受控于岩浆成分、喷发环境及后期蚀变作用, 直接影响其岩石物理性质和储集性能的多样性。矿物含量的定量计算是火山岩岩石物理模型构建和储层精细评价的关键。传统矿物含量的确定高度依赖录井人员对岩屑、岩心等实物样品的实验室鉴定, 并辅以薄片分析, 效率低, 难以满足当前油气田高效勘探开发对降本增效的迫切需求。以松辽盆地长岭断陷查干花地区为例, 火山岩矿物含量的精准计算面临诸多挑战:一方面, 除主要造岩矿物外, 工区内还含有一定数量的黑云母、辉石等暗色矿物, 会影响主要矿物的计算准确度; 另一方面, 部分凝灰岩经历了强烈的绢云母化作用, 导致原有矿物成分发生变化, 增加了计算的不确定性; 此外, 复杂的矿物组合和孔隙结构导致测井响应特征重叠, 传统方法难以有效区分和计算。
元素录井数据可在一定程度上反映岩石的化学成分, 而化学成分从根本上受控于矿物组成, 且不受暗色矿物光性干扰和蚀变产物晶体形态影响。因此, 基于元素含量计算矿物含量已成为研究热点。早期学者利用Al、Fe、K三元素含量求解高岭石、伊利石与钾长石含量, 计算结果具备良好精度[1]; Herron[2]创新性地提出氧化物闭合模型, 极大完善了矿物定量理论框架; 依托上述基础理论, 系统建立了元素-矿物转换定量关系, 将矿物地球化学反演手段运用于岩性划分、储层物性参数测算等地质实践工作中[3]。近年来, 机器学习算法凭借强大的建模能力和高维数据处理优势, 为复杂地质参数的定量计算开辟了新途径, 在矿物含量计算领域展现出巨大潜力[4, 5, 6]。研究表明, 支持向量机、随机森林、极端梯度提升树(XGBoost)等算法在利用测录井数据进行岩性和物性预测方面取得显著成效, 部分模型准确率可超过90%, 为智能化矿物含量计算提供了重要方法参考; 神经网络也被用于碎屑岩中石英、长石、黏土矿物、方解石、白云石的含量计算, 石英和长石的平均绝对误差分别控制在1.72%和4.5%以内[7]。但对于火山岩, 受复杂的矿物组合、暗色矿物和蚀变影响, 上述方法的计算精度和可靠性仍有限[8, 9, 10, 11]。
针对上述不足, 本文聚焦于火山岩矿物含量的定量计算, 以松辽盆地长岭断陷查干花地区火石岭组火山岩为研究对象, 基于元素录井数据, 对比岭回归、随机森林、XGBoost、轻量级梯度提升树(LightGBM)和神经网络5种主流机器学习算法, 通过多模型对比优选构建了矿物含量计算方法, 实现数据预处理、特征选择、模型训练与评估、矿物含量计算等流程的自动化, 以期提升计算效率和精度, 为后续火山岩岩石物理模型构建、储层“ 四性” 关系理解及火山岩油气藏智能化勘探开发提供坚实的技术支撑。
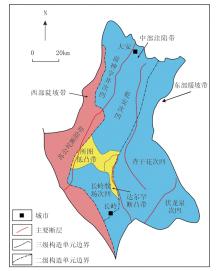
长岭断陷位于松辽盆地南部中央凹陷区, 属中生代断-坳复合型盆地, 内由多个次级断凹组成, 可划分为中部洼陷带、西部陡坡带和东部缓坡带3个二级构造单元, 发育乾安次凹、前神字井次凹、查干花次凹、长岭牧场次凹和伏龙泉次凹5个次级凹陷。研究区查干花次凹为其核心构造单元, 面积约800 km² , 基底为前古生界变质岩系, 上覆白垩系火石岭组火山-沉积地层(图1)[12]。
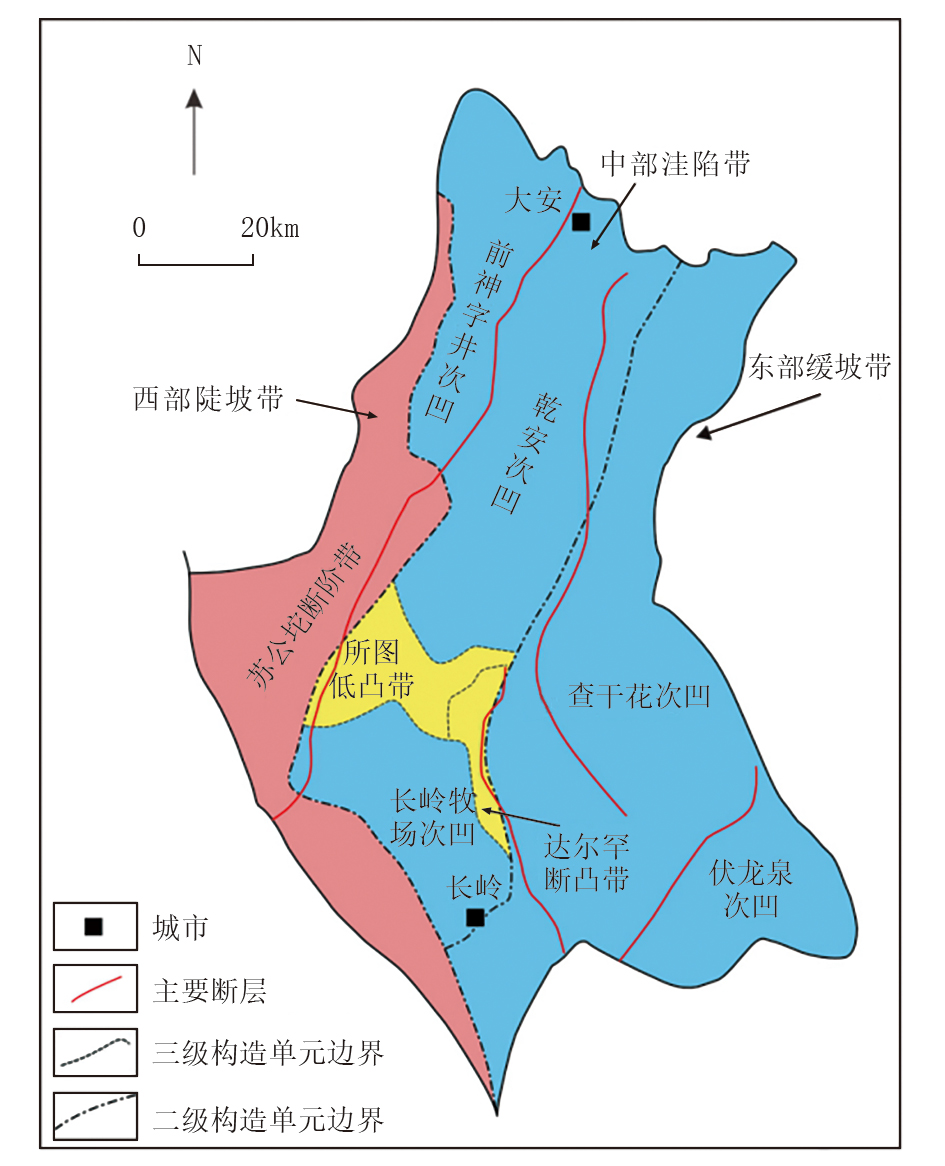 | 图1 长岭断陷查干花地区构造位置图 |
火石岭组火山岩以中酸性火山碎屑岩为主, 垂向上可分为3段:底部以溢流相火山熔岩夹爆发相凝灰岩为主, 厚度50~120 m; 中部发育火山沉积相的火山碎屑沉积岩类, 厚度30~80 m; 上部以水下爆发相中-粗粒凝灰岩为特征, 厚度80~150 m[13, 14]。
查干花地区火石岭组具有两个显著特征:一是火山碎屑岩以凝灰级为主, 角砾/集块级组分局部发育, 矿物颗粒细小、混合程度高; 二是普遍经历了绢云母化等蚀变作用, 暗色矿物(黑云母、辉石)发育。这种特殊的岩石构成与复杂的蚀变历史, 使得传统方法在矿物识别与岩石矿物含量计算中面临较大不确定性。元素录井可在一定程度上弥补上述不足, 且较常规基于岩心样品的实验手段能实现全井段密集采样, 并可与矿物含量数据相匹配, 形成大量的“ 元素-矿物数据对” , 为开展智能化矿物含量计算研究提供理想数据基础。
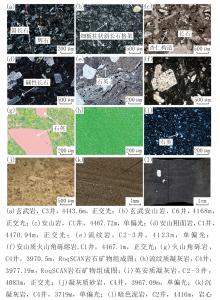
查干花地区火石岭组主要岩石类型包括火山熔岩、火山碎屑熔岩、火山碎屑岩、沉火山碎屑岩和火山碎屑沉积岩等火山岩及火山-沉积过渡岩类, 并发育喷发间歇期形成的正常沉积岩, 岩性复杂多变, 具体可见玄武岩、玄武安山岩、安山岩、安山粗面岩、流纹岩、安山质火山角砾熔岩、火山角砾岩、流纹质凝灰岩、英安质凝灰岩、凝灰质砂岩、沉凝灰岩、泥岩等发育(图2)。
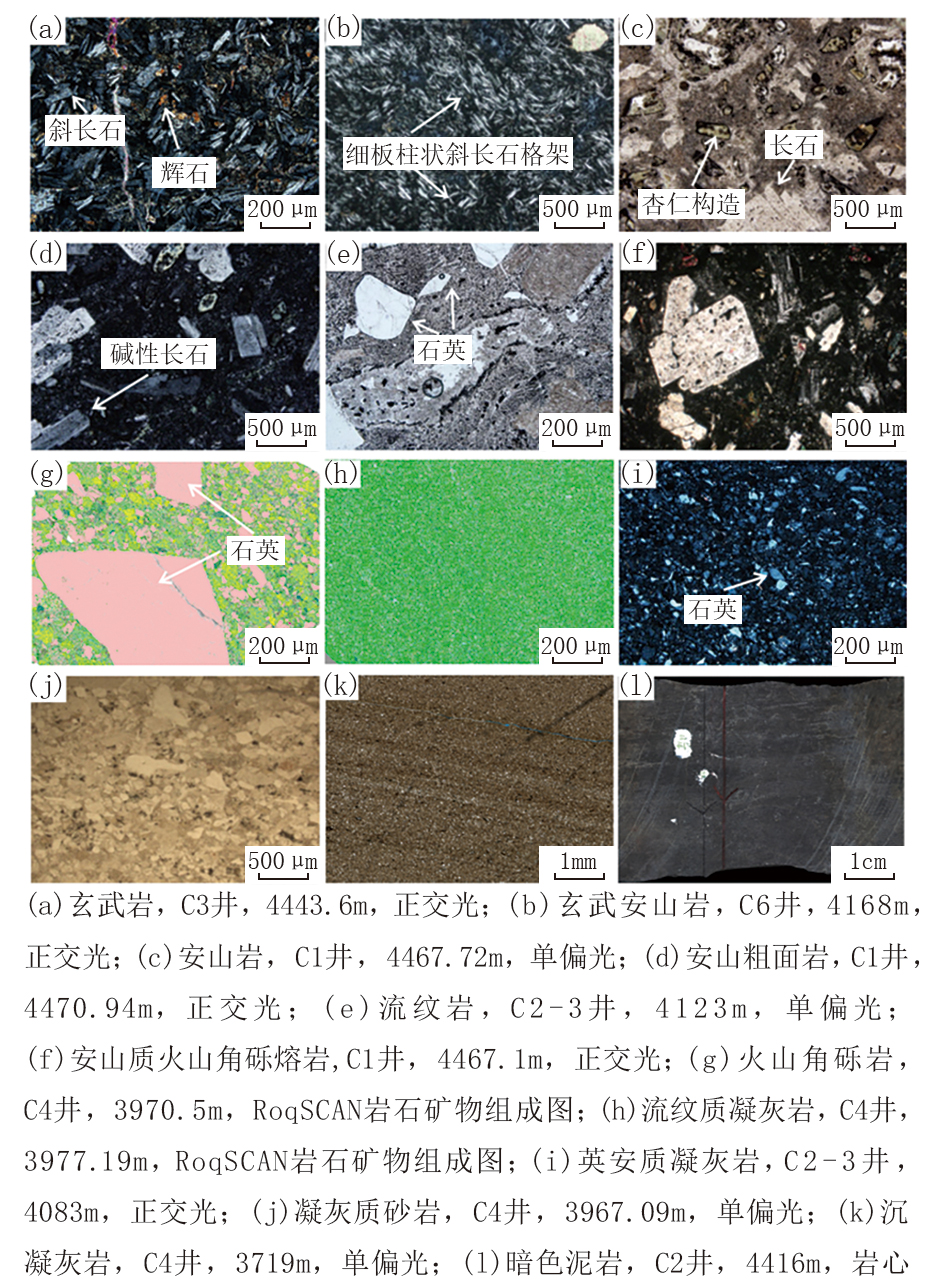 | 图2 研究区火石岭组主要岩石类型 |
基于元素录井数据计算矿物含量是一项复杂的回归任务。主流方法可归纳为3类:传统统计回归模型(岭回归)、树集成算法(以随机森林、XGBoost和LightGBM为代表)及神经网络。本节针对矿物含量计算任务, 结合算法机理、适用场景与性能边界, 对上述3类(5种)方法进行系统介绍。
岭回归是线性回归模型的一种改进算法, 专为处理特征多重共线性问题而设计。在矿物含量计算中, 元素录井数据(如Al和Si, K和Na)之间常存在高度相关性, 标准线性回归对此敏感, 易导致模型不稳定、计算方差大。岭回归通过在损失函数中引入L2正则化项(惩罚系数平方和), 约束模型权重, 有效抑制过拟合, 提升在共线性数据上的计算稳定性与泛化能力。其优势在于模型简单、计算高效、解唯一且易于解释, 是处理矿物计算特征间多重共线性问题的有效基线方法。
树集成算法通过构建并组合多个决策树提升计算性能, 在矿物含量计算中应用广泛且效果显著。本研究重点采用以下3种主流算法。
2.2.1 随机森林
随机森林通过构建大量决策树, 并进行计算平均值(回归任务)来工作。其核心在于“ 双重随机性” :对训练数据进行有放回抽样(Bootstrap), 为每棵树生成略有差异的训练集; 在树的每个节点分裂时, 仅随机选取一个特征子集进行候选。可在矿物含量计算过程中显著降低过拟合风险, 提升模型泛化能力, 但模型解释性仍有限[15]。
2.2.2 XGBoost
XGBoost是一种高效的梯度提升决策树, 其核心在于顺序构建决策树, 每棵新树进行学习时纠正前一棵树(或树集)的计算残差。在矿物含量计算过程中, XGBoost通常能达到较高的计算精度, 有效防止过拟合[16]。
2.2.3 LightGBM
LightGBM是另一种高性能的梯度提升决策树框架, 其优势在于训练速度快、效率高。其区别于XGBoost的关键创新在于基于梯度的单边采样:优先保留梯度较大(预测偏差较大)的样本进行训练, 从而提升信息利用效率。在矿物含量计算过程中, 其训练速度显著快于XGBoost, 但对于小工区的元素录井数据来讲, 提升训练速度的需求并不大[17, 18]。
神经网络算法是一种模仿生物神经网络结构和功能的模型, 其通过构建多层感知器来处理复杂的非线性关系。在矿物含量计算中, 神经网络能自动捕获元素组合与矿物含量间的高阶相互作用, 对噪声和缺失数据具有一定鲁棒性, 且可同时计算多种矿物含量。然而, 神经网络存在“ 黑箱” 问题, 可解释性差, 难以直观理解各特征对特定矿物含量计算的影响[19]。
上述算法各有特点, 构成了当前矿物含量计算的代表性方法体系:岭回归提供稳定线性基线; 树集成算法(随机森林、XGBoost、LightGBM)在计算精度、运算效率、鲁棒性和可解释性之间提供了不同的平衡点; 神经网络在数据充足时具备强大的非线性拟合潜力。本文基于对这些算法特性的深入理解, 综合发挥不同算法优势, 实现火山岩矿物含量的高精度、自动化计算。
本次研究选取长岭断陷查干花地区钻遇火石岭组的4口取心井, 共计1 087个岩屑样品及82块岩心样品, 并对上述4口井火石岭组全井段岩屑样品进行了元素录井及X射线衍射(XRD)矿物分析。元素录井数据包含Na、Mg、Al、Si、P、S、Cl、K、Fe等17种元素的质量百分比; 矿物数据选取石英、钾长石、钠长石、黏土矿物、黄铁矿、方解石、白云石的质量百分比含量, 经匹配形成了1 087个元素录井数据与矿物含量数据对。同时利用82块岩心扫描照片、岩石薄片及RoqSCAN 岩石矿物分析数据, 与XRD结果进行比对和校验, 以降低XRD测试过程中人为解谱误差和钻井液处理剂影响。需要注意的是, 研究区内火山碎屑岩以凝灰质岩为主体, 且普遍遭受绢云母化蚀变改造, 黏土矿物组分中伊利石占据绝对优势; 岩性扫描测井连续定量剖面同样证实地层黏土矿物以伊利石为主, 基于区内黏土矿物单一的组合特征, 因此验证过程中采用伊利石近似表征黏土矿物。
在岩屑XRD实验过程中, 重晶石的检测结果受到钻井液中加重剂的影响, 导致部分样品中出现重晶石含量异常, 不能真实反映地层原生矿物组成(表1)。为解决上述干扰问题, 通过岩屑XRD实验数据与RoqSCAN自动矿物分析结果的相关性分析, 对比两种方法在主要矿物识别和定量上的差异, 有效识别并校正因钻井液导致的重晶石异常含量; 同时, 结合RoqSCAN对黑云母的直接识别能力, 确定其在样品中的相对含量, 从而修正XRD中黑云母被误判为黏土矿物的问题(表2)。该方法显著提升了矿物含量分析的准确性和可靠性, 为地层矿物组成的精细评价提供了坚实的数据基础。
 | 表1 部分岩屑样品全岩XRD矿物含量 单位:% |
| 表2 部分岩屑样品RoqSCAN岩石矿物分析数据 单位:% |
研究区显著的岩性复杂性导致矿物组合与含量的高度多样性。不同岩性具有不同的原生矿物组成, 加之后期蚀变作用, 造成了矿物类型及其含量的波动与非均质性。同时, 元素录井数据是岩石化学成分的直接反映, 而化学成分根本上受控于矿物组成。因此, 岩性多样性及其伴随的矿物组合变化必然表现为元素录井值的显著差异(表3)。
| 表3 几类典型岩石矿物含量与元素录井均值数据 单位:% |
在数据预处理环节, 首先对原始元素录井数据与矿物含量数据进行全面的质量检查。对于检测发现的异常值, 通过箱线图分析、标准差法等多种统计手段进行识别, 并根据实际情况进行修正或剔除, 以降低极端值对模型训练的干扰。其次, 所有输入特征均进行标准化处理(转换为均值为0、方差为1的分布), 从而消除不同量纲和尺度对模型训练的影响。最后, 开展建模变量敏感性筛选工作。原始录井检测指标涵盖 Na、Mg、Al、Si、P、S、Cl、K、Fe等17项主、次量元素质量分数参数, 均可作为矿物定量反演的潜在输入特征。为剔除信息冗余、弱化元素间多重共线性干扰, 采用Pearson相关系数法完成全元素与主要矿物组分间的相关性分析, 最终选取Al、Ca、Fe、K、Mg、Mn、Na、Si共8种高敏感性元素作为机器学习反演模型的核心输入参数。上述多层次的数据预处理措施, 有效提升了数据的质量和一致性, 为后续的模型训练奠定了坚实基础。
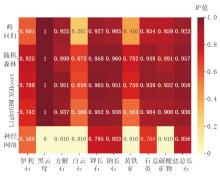
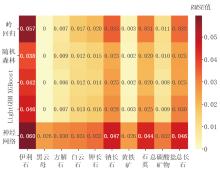
利用上述数据集, 以筛选出的8种元素作为模型输入特征, 分别选取岭回归、随机森林、XGBoost、LightGBM和神经网络5种算法对主要矿物含量进行计算, 以计算总体与具体矿物的决定系数(R2)(图3)和均方根误差(RMSE)(图4)作为评价指标。R² 用于衡量模型对真实值的拟合优度, 取值越接近1表示模型计算越准确; RMSE反映模型计算值与真实值之间的平均偏差, 数值越小表示模型误差越低。其中, 主要参与计算的矿物包括伊利石、黑云母、方解石、白云石、钾长石、钠长石、黄铁矿、石英, 以及总碳酸盐矿物(方解石、白云石)和总长石(钾长石、钠长石)。
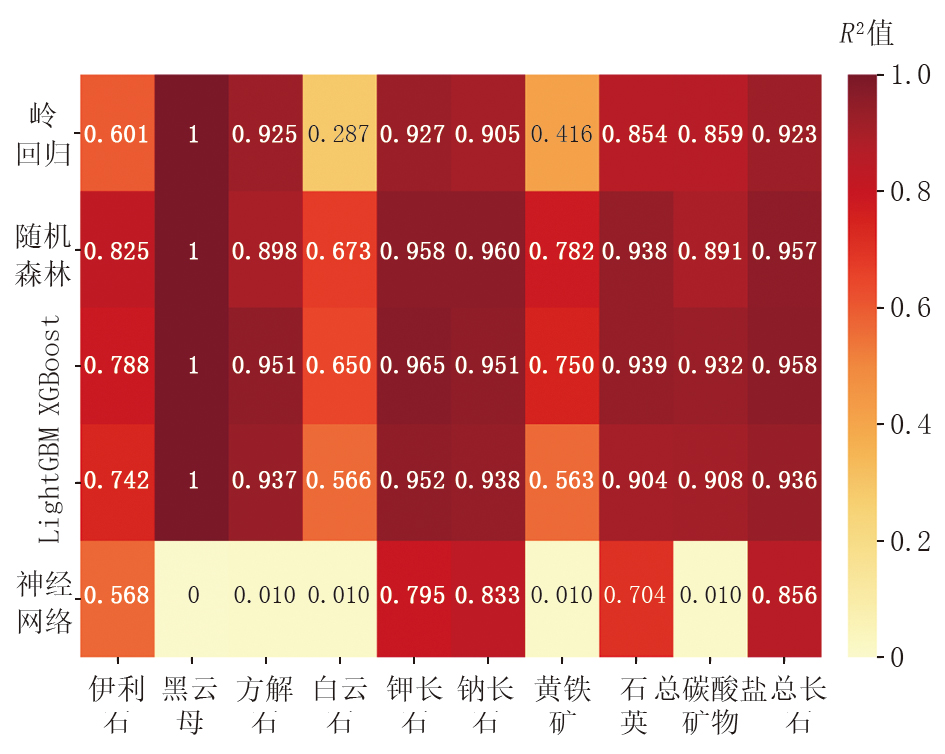 | 图3 各模型在不同矿物含量计算中的R² |
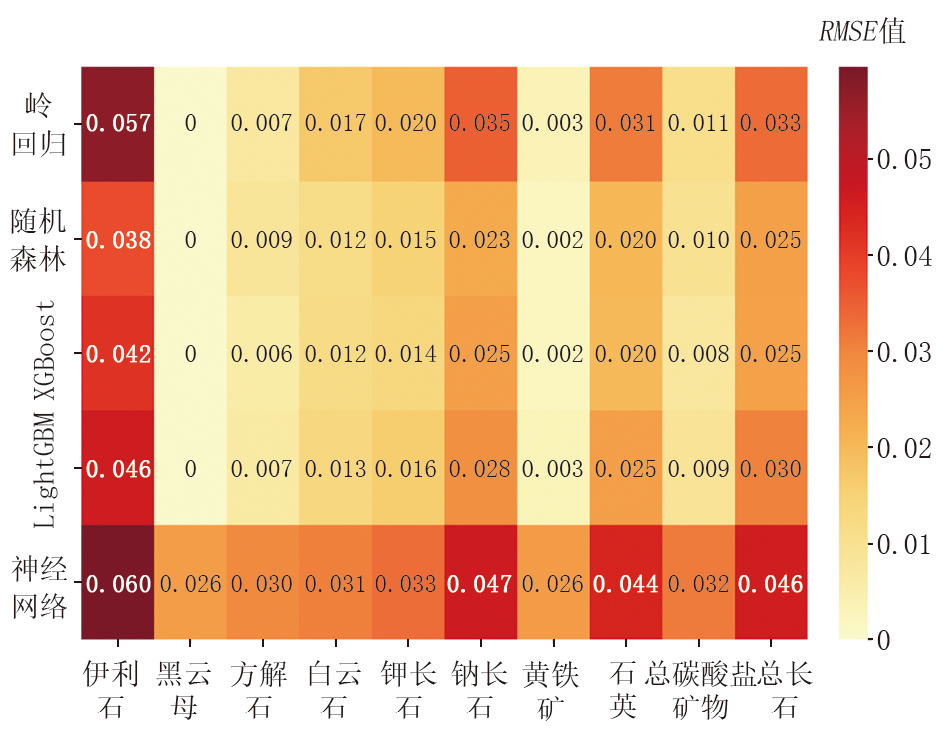 | 图4 各模型在不同矿物含量计算中的RMSE |
从图3、图4看出, 随机森林和XGBoost表现并列最优, LightGBM次之, 岭回归作为线性基准表现稳健但精度有限, 神经网络在该数据集上基本不适用。
随机森林平均决定系数R2=0.888, 平均均方根误差RMSE=0.015 3, 为所有算法中综合误差最低。在主要矿物(黑云母、方解石、钾长石、钠长石、石英), 以及总碳酸盐矿物和总长石上, R2均接近或达到1.0, 表明拟合近乎完美; 即使在较难预测的伊利石和黄铁矿上, R2也分别达到0.825和0.782, 显著优于其他模型, 其集成平均机制有效提升了非线性建模能力和抗噪声性能。XGBoost平均R2=0.888, 平均RMSE=0.015 5, 与随机森林旗鼓相当, 部分矿物略有超越。主要矿物R2均高于0.95, 伊利石和黄铁矿的R2分别为0.788和0.750, 精度同样高于其他模型, 其梯度提升框架对复杂地球化学关系具有较强的拟合能力。
LightGBM平均R2=0.844, 平均RMSE=0.017 8, 整体性能略逊于前两者, 但主要矿物R2仍在0.9以上, 伊利石和黄铁矿R2分别为0.742和0.563, 计算效率较高。岭回归平均R2=0.77, 平均RMSE=0.021 6, 作为线性正则化方法, 主要矿物R2均高于0.85, 但对伊利石(R2=0.601)和黄铁矿(R2=0.416)等非线性强、关系复杂的矿物拟合能力明显不足, 整体表现稳健但精度有限。
神经网络在本数据集上的表现远逊于其他算法。多数矿物(黑云母、方解石、白云石、黄铁矿、总碳酸盐矿物)的R2接近0, 表明模型未能有效捕捉元素与矿物含量的映射关系。主要原因可能包括:样本量有限, 不足以支撑深层网络训练; 特征与目标变量之间的相关性较弱, 线性或简单非线性关系并非神经网络擅长; 模型结构(层数、神经元数)及超参数未充分适配该地质数据特性, 导致过拟合或欠拟合。因此, 在该应用场景中, 神经网络无法取得较好的效果。
综上, 在未开展矿物分类的通用建模场景中, 随机森林与XGBoost为适配性更强的基准机器学习算法; 若需进一步提升矿物含量反演精度, 则可根据不同算法在计算不同矿物含量的R2和平均RMSE上采用分矿物优选的专属子模型, 并以.pkl格式保存。
以训练集中的C 2-3井为例, 对模型进行回判分析, 以检验其对训练样本的拟合能力。该结果不作为模型泛化能力评估。选取理由如下:①C 2-3井钻遇火石岭组, 并在4 219.4~4 226.40 m、4 269.22~4 276.22 m井段取心, 可用于矿物含量计算结果验证; ②该井岩屑连续取样, 可满足前述算法所需元素录井数据及用于验证的XRD数据; ③该井进行了岩性扫描测井, 可用于对比分析和算法迭代优化。
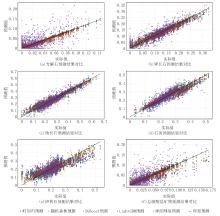
各模型预测值与实际值的散点分布如图5所示。方解石、钾长石、钠长石、石英、伊利石在不同机器学习模型下的计算效果整体较好, 大部分数据点分布在理想计算线(黑色虚线)附近, 说明模型能够较为准确地捕捉实际值与计算值之间的关系。具体来看, 岭回归、随机森林、XGBoost、LightGBM等模型在这些矿物的计算中均表现出较高的拟合度, 尤其是在钠长石、石英等矿物上, 计算点与理想线高度重合, R² 较高, RMSE较低, 表明模型具有较高计算精度。部分矿物(如方解石、伊利石)在低含量区间存在一定的离散点, 但整体趋势依然与理想线一致, 说明模型对主要数据的拟合效果良好(图5)。除此之外, 黑云母、黄铁矿等矿物在研究区岩心中整体含量偏低且分布不均, 各模型对含量的预测精度明显下降。
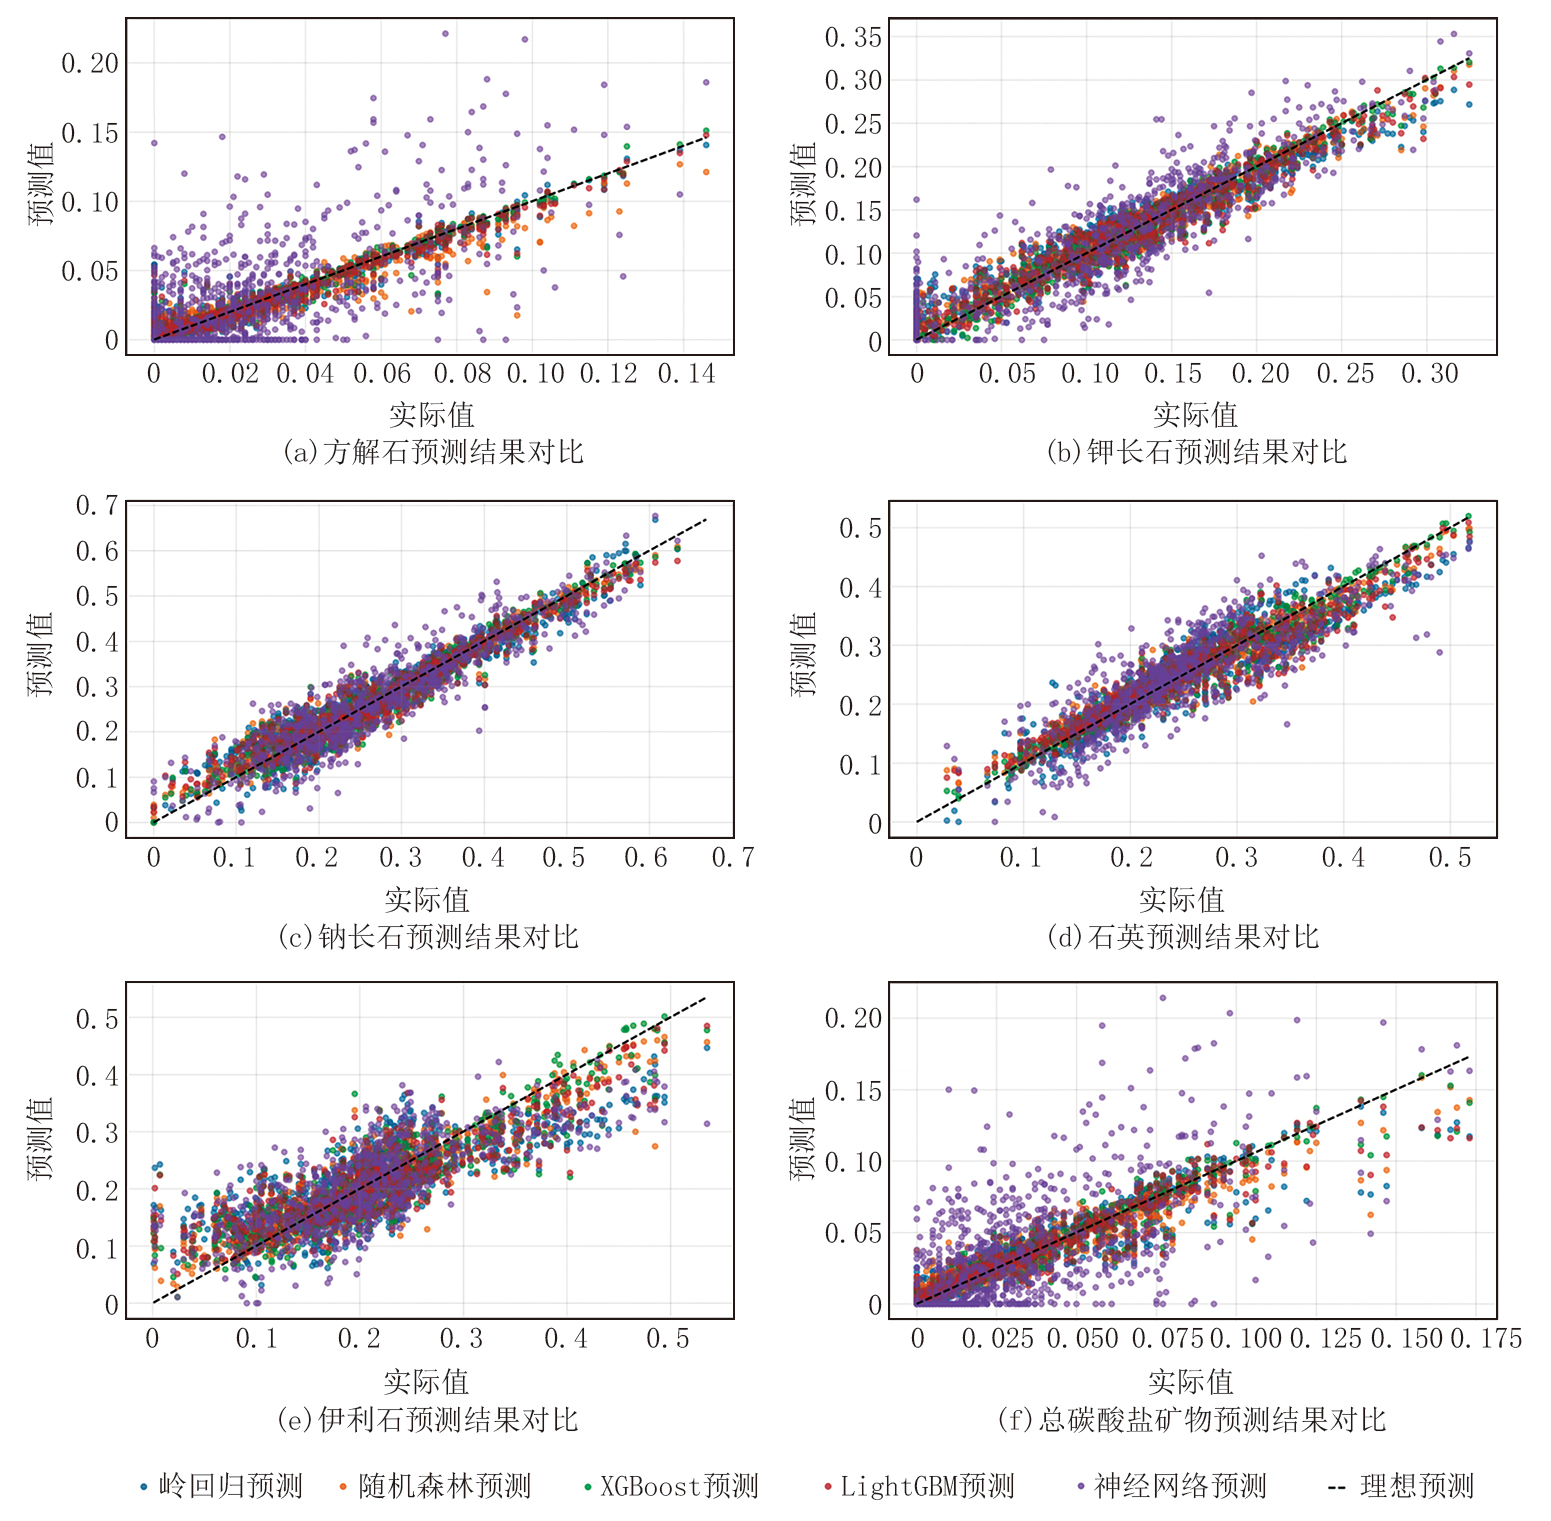 | 图5 5种算法预测主要矿物含量散点分布图 |
各模型在不同矿物上的R² 和RMSE详见表4。从表4可以看出, 方解石在XGBoost、LightGBM模型的R² 均在0.90以上, RMSE低至0.01, 说明这些模型对方解石的计算精度极高、拟合效果非常好。钾长石在XGBoost表现最佳, R² 高达0.94, RMSE最低(0.01); 随机森林和LightGBM也有很高的R² (均0.90以上), 岭回归略低但也在0.89以上。钠长石在随机森林、XGBoost和LightGBM模型中的R² 均在0.91以上, RMSE低至0.02, 表现优异。石英在随机森林、XGBoost模型中的R² 均在0.90以上, RMSE约0.02, 表现突出。伊利石在各模型R² 整体偏低, 随机森林最高(0.79), XGBoost(0.76)、LightGBM(0.71)、岭回归(0.59)次之, 神经网络最低(0.54)。
| 表4 主要矿物含量计算在各模型中的表现 |
XGBoost、随机森林、LightGBM在大多数矿物的计算中表现最为优异, R2普遍高于0.90, RMSE较低, 尤其适合用于矿物含量的高精度计算。岭回归在部分矿物(如方解石、钾长石、总碳酸盐矿物)上也有较好表现, 但在伊利石等复杂矿物上略逊一筹。神经网络在本数据集下整体表现不如集成模型, 尤其在方解石、石英、伊利石上R2明显偏低, RMSE较高, 可能与参数设置或数据特征有关。伊利石的计算难度最大, 各模型R2均低于0.85, 提示后续可考虑特征工程或模型优化。这些结果表明, 集成学习方法(XGBoost、随机森林、LightGBM)在矿物含量计算方面具有显著优势, 能够为矿物定量计算提供可靠的技术支撑。
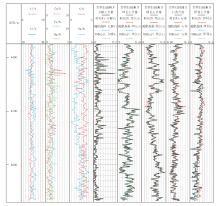
将随机森林、XGBoost、岭回归3种模型计算的石英、钠长石、钾长石、方解石、伊利石含量与岩性扫描测井解释结果进行对比(图6, LightGBM和神经网络因验证精度相对较低, 未在图中展示), 从图6可以看出, 数据范围与趋势高度一致。
 | 图6 C 2-3井主要矿物含量计算结果与岩性扫描测井对比 |
针对松辽盆地长岭断陷查干花地区火石岭组火山岩, 建立了一种基于元素录井与机器学习的矿物含量计算方法。方解石、钠长石、石英、钾长石、伊利石在不同机器学习模型下的计算效果整体较好。岭回归、随机森林、XGBoost和LightGBM等模型在这些矿物的计算中均表现出较高的拟合度, 尤其是在钠长石、石英等矿物上, 计算点与理想线高度重合, R² 较高, RMSE较低, 表明模型具有较强的计算精度。通过与岩性扫描测井中矿物含量数据进行对比, 模型计算结果与测井解释结果在数据范围与趋势高度一致, 进一步印证了该方法的合理性, 为长岭地区火石岭组火山岩岩石物理建模、储层“ 四性” 关系分析及智能化勘探开发提供了可靠的技术支撑。
需要注意的是, 本方法仍存在一定局限性:方沸石、辉石等矿物因含量低未纳入系统验证; 目前仅验证于查干花地区火石岭组, 其推广性有待进一步检验。后续可通过扩充数据集、优化特征工程及超参数调优, 探索该方法在其他区块火山岩中的适用性。
编辑 卜丽媛
| [1] |
|
| [2] |
|
| [3] |
|
| [4] |
|
| [5] |
|
| [6] |
|
| [7] |
|
| [8] |
|
| [9] |
|
| [10] |
|
| [11] |
|
| [12] |
|
| [13] |
|
| [14] |
|
| [15] |
|
| [16] |
|
| [17] |
|
| [18] |
|
| [19] |
|